El espejismo de la velocidad: Por qué la arquitectura acelera y las herramientas solo “tipean” más rápido
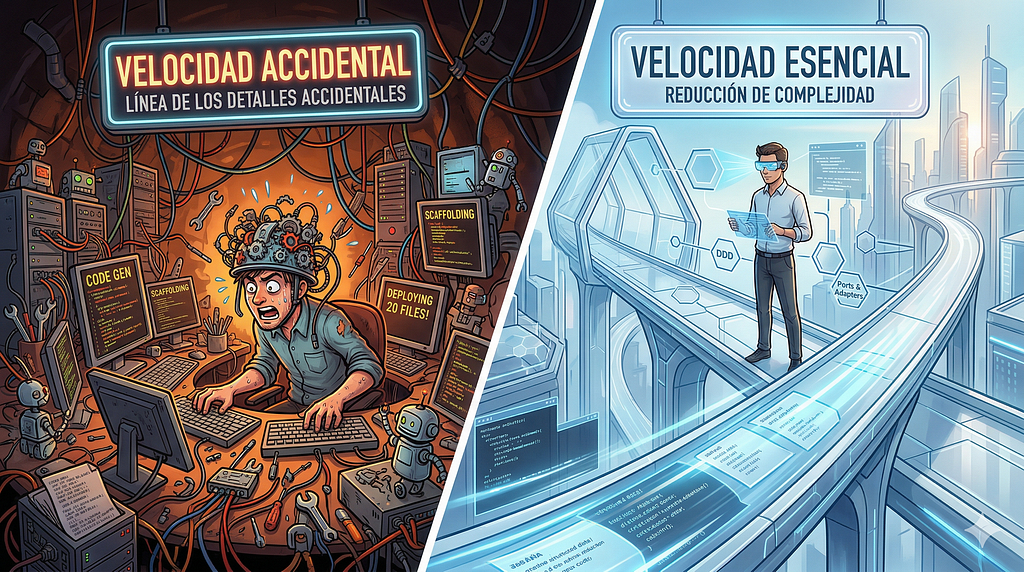
Hay una escena mágica que se repite todo el tiempo en la industria del software: alguna herramienta genera scaffolding, autocompleta funciones enteras, despliega con un clic. La demo dura tres minutos. Todos aplauden. Meses después, el proyecto está empantanado en exactamente los mismos problemas de siempre — solo que tiene cada vez más archivos que apuntan a resolver algo, aunque de forma pobre.
¿Qué pasó? Que confundimos producir código con avanzar.
La trampa de la velocidad de salida
La industria del software tiene una obsesión que rara vez examina: la velocidad de salida. Líneas por hora. Features por sprint. Deploys por día. Todo se mide en volumen y frecuencia. Pero hay un problema evidente con esta métrica: correr en la dirección equivocada solo te aleja más rápido de la meta.
La velocidad que importa es otra. Es el tiempo que transcurre entre concebir una idea y tenerla funcionando en producción de forma estable. Y, de forma poco intuitiva, esa velocidad no depende de qué tan rápido tipeás, sino de cuántos problemas innecesarios evitás crear en el camino.
Dicho de otra forma, la velocidad máxima de un proyecto no la determina el motor, sino que la determinan los frenos y el volante.
Lo accidental y lo esencial: la distinción que nadie quiere hacer
En 1986, Fred Brooks publicó No Silver Bullet, un ensayo que sigue siendo incómodamente relevante. Su tesis central distingue dos tipos de complejidad en el software.
Por un lado, **** la complejidad accidental es todo lo que rodea al problema pero no es el problema: configuraciones, sintaxis verbosa, boilerplate, integración de librerías, pipelines de CI/CD. Es el ruido de fondo del desarrollo.
Y por otro lado **** tenemos a la complejidad esencial, que representa al problema de negocio en sí mismo: las reglas, los estados válidos, las invariantes que el sistema debe respetar, etc.
La distinción parece obvia. Pero en la práctica, la confundimos constantemente. Y la confundimos porque las herramientas que más visibilidad tienen en la industria atacan casi exclusivamente la complejidad accidental, y lo hacen de forma espectacular (y sobre todo en términos de marketing).
Un generador de código (aunque sea IA) que crea 20 archivos de boilerplate en un segundo se siente veloz. Pero lo que realmente hizo fue darte 20 archivos que ahora hay que mantener, testear y — lo más costoso — entender. No resolvió tu problema de negocio; solo amobló la habitación antes de que decidieras si la casa tiene buenos cimientos.
El código más rápido es el que no existe
Acá está la inversión de perspectiva que propongo. Imaginá dos desarrolladores trabajando en el mismo sistema de facturación.
El primero usa a la IA para generar una función de validación de 100 líneas en dos segundos. La función chequea que el monto no sea negativo, que la fecha esté en el rango correcto, que el cliente exista, que el estado de la factura permita la operación. Funciona. Se commitea. A producción.
Pero en cambio, el segundo se detiene y modela el dominio con tipos. Define MontoPositivo como un tipo que no puede contener un valor negativo — no porque se valide en runtime, sino porque la construcción misma del tipo lo impide. Define los estados de una factura como una unión discriminada: Borrador | Emitida | Pagada | Anulada, donde las transiciones válidas son las únicas funciones que existen. No hay función de validación de 100 líneas porque no hay forma de crear un estado inválido.
El primero fue “más rápido” en la métrica de salida. El segundo eliminó una categoría entera de bugs que el primero va a perseguir durante meses. Entonces, vale preguntarse, ¿quién fue más rápido en la métrica que importa?
Esto no es teoría. Es la diferencia entre escribir 100 líneas de código accidental en 2 segundos y diseñar un modelo que hace que esas 100 líneas no sean necesarias. En el segundo caso, ganaste velocidad infinita sobre ese bloque: el mantenimiento futuro de código que no existe, es cero.
Tres espejismos concretos (y sus antídotos)
Y aquí resulta interesante presentar tres espejismos que se repiten muy a menudo en la industria.
Las herramientas de IA generativa son impresionantes para reducir complejidad accidental. Generan boilerplate, convierten pseudocódigo en implementaciones, sugieren patrones conocidos. Pero no diseñan arquitectura, y en una base de código con un diseño pobre, solo aceleran la producción de deuda técnica.
El antídoto no es rechazar estas herramientas — es invertir el orden. Lo que primero es importa es el modelo. Definí los tipos, los contratos, los límites del dominio. Después dejá que la IA te ayude con el cableado entre piezas que ya tienen la forma correcta. La IA como albañil rápido es útil. La IA como arquitecto improvisado es peligrosa.
Espejismo 2: “Kubernetes nos da escalabilidad”
Desplegar 20 microservicios con Kubernetes para un sistema que atiende a 500 usuarios introduce complejidad de red, problemas de consistencia eventual, transacciones distribuidas y una curva de debugging que multiplicaría el sufrimiento de cualquier equipo. Todo “porque es escalable”.
El antídoto es un monolito bien modularizado donde los Bounded Contexts están claros. Los módulos tienen interfaces definidas y pueden extraerse a servicios independientes el día que realmente haga falta. La velocidad viene de no tener que lidiar con latencia de red ni con sagas de compensación para operaciones que, en un monolito, serían una transacción de base de datos.
Espejismo 3: “Agregamos tests para todo, así vamos seguros”
Testear exhaustivamente un modelo mal diseñado es como ponerle más cerraduras a una puerta que da a una pared. Si tu modelo permite estados inválidos, vas a necesitar miles de tests para cubrir las combinaciones. Si tu modelo los elimina por construcción, los tests se enfocan en lo que importa: la lógica de negocio.
El antídoto **** es diseñar primero para que los estados inválidos sean irrepresentables. Los tests que sobreviven son los que verifican comportamiento, no los que compensan debilidades del modelo.
La arquitectura como sistema de frenos
Hay una analogía que me resulta inevitable. En las carreras de autos, los frenos no existen para ir más lento — existen para poder tomar las curvas a mayor velocidad sin salir de la pista. Un auto sin frenos no es rápido; es incontrolable.
La arquitectura y el diseño cumplen exactamente esa función en el software. No son “gastos” que retrasan el desarrollo. Son las restricciones que te permiten acelerar con confianza. Un sistema bien modelado te deja agregar features sin miedo, refactorizar sin rezar y desplegar sin drama.
Entonces, ¿cómo se invierte la prioridad?
No se trata de rechazar las herramientas, ni de diseñar durante seis meses antes de escribir una línea de código. Se trata de cambiar el orden en el que atacamos los problemas.
Primero, simplificá el modelo. Antes de tocar el teclado (incluso para promptear), preguntate: ¿este diseño permite estados que no deberían existir? ¿Puedo reducir el espacio de posibilidades? Cada estado inválido que eliminás por diseño es un bug que nunca vas a tener que debuggear.
Después, delegá la verificación a la máquina. Usá tipos fuertes, contratos, invariantes. Si el compilador puede encontrar el error, no lo busques vos a las 3 de la mañana con un debugger o en logs que pusiste por las dudas a lo largo de todo el código.
Por último, automatizá lo accidental. Ahora sí: generá el boilerplate, usá scaffolding, dejá que la IA te ayude con el cableado. Pero hacelo sobre una estructura que ya resolvió lo esencial.
La próxima vez que alguien te muestre una herramienta que “escribe código 10 veces más rápido”, preguntate: ¿10 veces más rápido hacia dónde? Porque la velocidad sin dirección tiene otro nombre: desperdicio.
Publicado también en Medium