QuickCheck vs. testing tradicional como arnés determinista en la era de GenAI
Se supone que 2026 es el año en que los agentes de IA generativa empezarán a hacerse cargo de flujos de trabajo complejos de extremo a extremo. Sin embargo, la industria se está chocando contra un muro matemático: la fiabilidad compuesta.
Andrej Karpathy lo bautizó como la march of nines en su conversación con Dwarkesh Patel (octubre 2025). Su tesis, refinada durante cinco años liderando Autopilot en Tesla, es brutalmente simple: cada “nueve” adicional de fiabilidad — pasar de 90% a 99%, de 99% a 99.9%, y así — requiere aproximadamente el mismo esfuerzo de ingeniería que todos los anteriores juntos. No es una curva lineal; es logarítmica.
El problema en agentes es que esa fiabilidad se compone multiplicativamente. Un workflow de 10 pasos donde cada paso tiene 95% de éxito termina con una fiabilidad end-to-end de aproximadamente 0.95^10 ≈ 60%. Con 90% por paso, se caería a ~35%. En otras palabras, dos de cada tres ejecuciones no son correctas, y nunca en el mismo lado dos veces.
No obstante, la respuesta dominante de la industria ha sido empaquetar “skills” en archivos Markdown con prompts cada vez más elaborados, esperando que el modelo no alucine ni se saltee pasos. Pero la esperanza no es una estrategia de ingeniería. Para ejecutar código generado por IA en producción necesitamos abandonar la mentalidad de feature factory guiada por prompts y volver a los cimientos: poner motores probabilísticos sobre rieles deterministas.
Y acá es donde el debate sobre cómo probamos software — test unitario, test de integración y QuickCheck — cobra relevancia nuevamente.
El arnés tradicional: unitario e integración como andamiaje estructural
En desarrollo clásico, los tests unitarios validan funciones aisladas y los de integración aseguran que los componentes hablen entre sí. Cuando metemos GenAI en el ciclo — ya sea como copiloto o como agente autónomo — estos tests dejan de ser meros validadores, y se convierten en el andamiaje estructural que hace viable delegar generación de código.
El caso más interesante hoy es el sistema Minions de Stripe, documentado en su blog de ingeniería en febrero de 2026. Stripe tiene agentes autónomos que mergean más de 1.300 PRs por semana sin código humano — solo revisión humana al final. ¿Cómo lo logran a esa escala, sobre un codebase de cientos de millones de líneas en Ruby con Sorbet y librerías propias que ningún LLM público vio en su entrenamiento?
La respuesta no es un modelo mejor. Es un harness de tres tiers de feedback:
- Linters locales que corren en menos de 5 segundos en cada push. Si hay un error de sintaxis, el agente se entera inmediatamente y lo arregla de forma barata.
- CI selectivo sobre los más de 3 millones de tests de Stripe. Correrlos todos sería imposible, así que el sistema ejecuta solo los relevantes a los archivos modificados.
- Cap pragmático de iteraciones: si el agente no puede arreglar un test fallido en dos intentos, escala a un humano. Stripe entendió que los LLMs muestran rendimientos decrecientes al reintentar el mismo problema — un tercer intento solo quema tokens.
La clave conceptual está en lo que Stripe llama blueprints: secuencias de nodos donde algunos ejecutan código determinista (linters, commits, push) y otros corren agentes en loop. La creatividad del LLM queda acotada por gates determinísticos que no puede saltearse. El agente provee el contenido bruto, pero la infraestructura impone el proceso.
Esto es exactamente la “puesta sobre rieles” que mencionaba al principio. Y se construye con el arnés tradicional — tests, linters, CI — que ya teníamos hace 20 años. De esta forma, la novedad no es la herramienta, sino dónde se la coloca dentro del loop.
Sin embargo, no podemos dejar de notar que hay un techo. Tests unitarios y de integración son comprobaciones basadas en ejemplos: dado X, espero Y. Son excepcionales para prevenir regresiones conocidas, e insuficientes cuando el autor del código es un motor estadístico capaz de introducir casos límite semánticos que ningún programador humano imaginaría escribir.
La revancha de los métodos formales: property-based testing
Acá es donde entra el rigor académico que la industria suele postergar en favor de la velocidad de entrega. Si vamos a delegar generación de lógica a un LLM, necesitamos probar invariantes, no solo ejemplos. Porque si bien los modelos generativos son expertos en producir código que compila y pasa los tests existentes, fácilmente pueden violar lógica de dominio. Y ese código es el más peligroso, porque muchas veces hasta tiene apariencia de corrección.
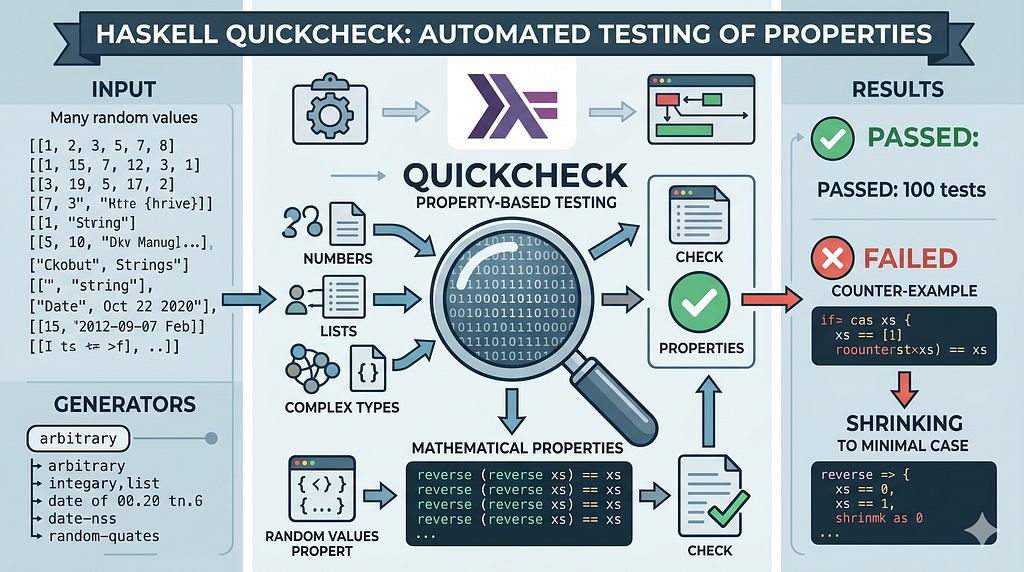
QuickCheck, cuyo paper original es Claessen y Hughes, ICFP 2000, inauguró la disciplina del property-based testing. La idea es elegante: en lugar de escribir casos de prueba específicos, escribís las propiedades matemáticas y semánticas que la función debe satisfacer siempre, y la herramienta genera cientos de inputs aleatorios para intentar romperlas. Cuando encuentra un contraejemplo, lo minimiza (shrinking) hasta dejarlo en su forma más simple.
QuickCheck nació en Haskell pero ya hay implementaciones en más de 40 lenguajes: Hypothesis (Python), fast-check (TypeScript), ScalaCheck, Kotest, jqwik (Java), proptest (Rust). Esto quiere decir que no es exótico, y está al alcance de la mano.
De esta forma, las propiedades dejan de ser una curiosidad académica y se vuelven nuestro contrato de seguridad, y sobre todo en la validación de estados inesperados. Property-based testing produce cientos de casos generados aleatoriamente contra el código del agente hasta encontrar la fisura semántica que ningún ejemplo anticipó.
Por ejemplo, imaginemos que le pedimos a un agente que implemente una función para aplicar descuentos a un carrito de compras. El agente devuelve el siguiente código:
type CartItem = { price: number; quantity: number };

function applyDiscount(items: CartItem[], discountPct: number): number {
  const subtotal = items.reduce((acc, i) => acc + i.price * i.quantity, 0);
  return subtotal * (1 - discountPct / 100);
}
Compila, y pasa los tests unitarios obvios:
test("10% off de $100 = $90", () => {
  expect(applyDiscount([{ price: 100, quantity: 1 }], 10)).toBe(90);
});
Da Verde. Listo para mergear, ¿no? Claro que no. Veamos qué pasa cuando expresamos las propiedades de dominio que cualquier función de descuento debe satisfacer, sin importar el input:
import fc from "fast-check";

// Propiedad 1: el total con descuento nunca debe ser negativo.
test("total nunca es negativo", () => {
  fc.assert(
    fc.property(
      fc.array(fc.record({
        price: fc.float({ min: 0, max: 10000, noNaN: true }),
        quantity: fc.integer({ min: 0, max: 100 })
      })),
      fc.float({ min: 0, max: 100, noNaN: true }),
      (items, discount) => applyDiscount(items, discount) >= 0
    )
  );
});
// Propiedad 2: un descuento del 0% debe devolver exactamente el subtotal.
test("descuento 0% es identidad", () => {
  fc.assert(
    fc.property(
      fc.array(fc.record({
        price: fc.float({ min: 0, max: 10000, noNaN: true }),
        quantity: fc.integer({ min: 0, max: 100 })
      })),
      (items) => {
        const subtotal = items.reduce((a, i) => a + i.price * i.quantity, 0);
        return Math.abs(applyDiscount(items, 0) - subtotal) < 0.001;
      }
    )
  );
});
// Propiedad 3: mayor descuento ⇒ menor o igual total (monotonicidad).
test("monotonicidad del descuento", () => {
  fc.assert(
    fc.property(
      fc.array(fc.record({
        price: fc.float({ min: 0.01, max: 10000, noNaN: true }),
        quantity: fc.integer({ min: 1, max: 100 })
      }), { minLength: 1 }),
      fc.float({ min: 0, max: 50, noNaN: true }),
      fc.float({ min: 50, max: 100, noNaN: true }),
      (items, low, high) => applyDiscount(items, high) <= applyDiscount(items, low)
    )
  );
});
La primera propiedad falla. fast-check encuentra el contraejemplo y lo reduce automáticamente (shrinking) hasta su forma mínima:
Property failed after 7 tests
  Counterexample: [ items: [], discount: 150 ]
  Got value: -0  // y peor: con cualquier item, total negativo
El agente nunca validó que discountPct estuviera entre 0 y 100. Un descuento del 150% produce totales negativos —que en producción se traduce en pagarle al cliente por comprar. Ningún test basado en ejemplos hubiera atrapado esto sin que un humano específicamente pensara en el caso "descuento mayor a 100". Las propiedades sí, porque definen el contrato semántico que el código debe cumplir siempre.
Esta es exactamente la categoría de bug que los LLMs introducen sistemáticamente: código localmente correcto que viola invariantes globales del dominio.
El diseño limpio como condición de posibilidad
Y hay una conclusión incómoda escondida: los LLMs no son el fin de la ingeniería de software. Son el fin del código como trabajo manual. Lo que emerge como la disciplina valiosa es la orquestación, el diseño limpio y los métodos formales para ejecutar código generado de forma segura.
Construir un harness robusto para agentes — máquinas de estado estrictas, aislamiento de contextos, validación automática en loop, propiedades formales en los bordes — requiere pensamiento sistémico profundo. Si tu sistema no tiene una denotación semántica clara (qué significa cada estado, qué garantías ofrece cada transición) y una arquitectura pensada para resistir la aleatoriedad, la IA no te va a salvar: va a acelerar la creación de deuda técnica a una velocidad que el equipo humano no puede absorber.
El trabajo de Birgitta Böckeler sintetiza bien la dirección: el agente es solo el modelo más el harness, y la mayor parte del valor de ingeniería se está moviendo al harness. Eso es Ley de Variedad Requerida de Ashby aplicada a IA: tu sistema de control necesita tener al menos tanta variedad como el sistema que controla. Reducir la variedad del agente — comprometiéndolo a topologías acotadas — hace que un harness comprehensivo sea alcanzable.
La transición de los próximos años no se va a tratar de quién tiene el mejor modelo. Se va a tratar de quién tiene el arnés de validación más riguroso. Y paradójicamente, para dominar el futuro del software escrito por IA vamos a tener que volver a las raíces más formales y funcionales de las ciencias de la computación: tipos, propiedades, invariantes, máquinas de estado, métodos formales.
Lo viejo vuelve. Pero esta vez no como nostalgia académica, sino como condición de posibilidad para que el código funcione en producción.
Referencias
- Karpathy, A. & Patel, D. — AGI is still a decade away (Dwarkesh Podcast, octubre 2025). Transcripción
- Stripe Engineering — Minions: Stripe’s one-shot, end-to-end coding agents (febrero 2026). Parte 1 · Parte 2
- Claessen, K. & Hughes, J. — QuickCheck: A Lightweight Tool for Random Testing of Haskell Programs (ICFP 2000). DOI · PDF
- Böckeler, B. — Harness Engineering for Coding Agent Users (martinfowler.com). Artículo
- Chen, T.Y. et al. — Metamorphic Testing: A New Approach for Generating Next Test Cases (arXiv:2002.12543)
Publicado también en Medium