Sistemas de Tipos para máquinas que programan
Tipos Algebraicos de Datos, Typeclasses y arquitectura verificable cuando el que escribe el código es un agente
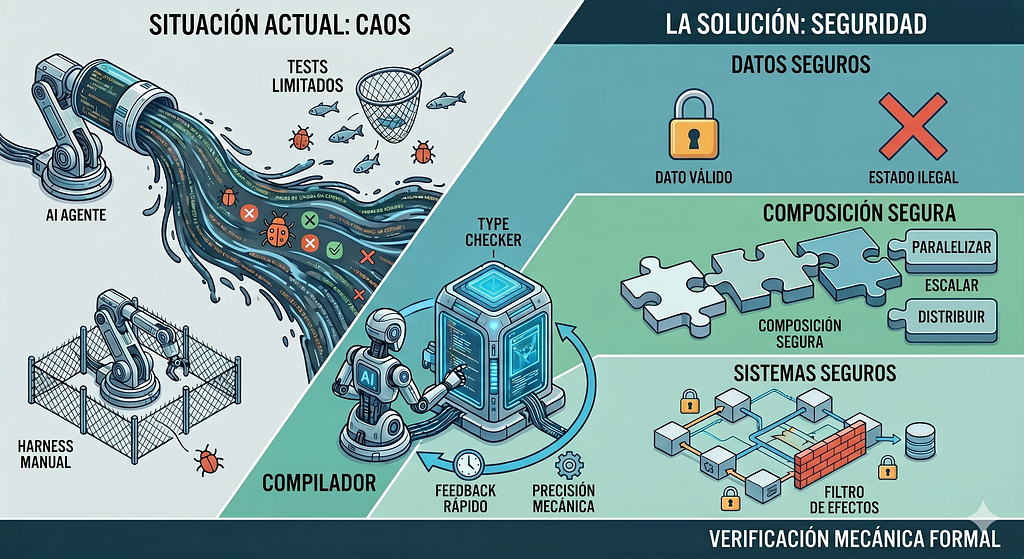
Durante sesenta años el cuello de botella del software fue escribir el código. Por eso casi todas nuestras herramientas optimizan su producción: autocompletado, frameworks, scaffolding, snippets. Pero los agentes acaban de cambiar esa ecuación, y generar mayor volumen de código se volvió más barato. Sin embargo, lo caro, lo escaso, lo que ahora vale, es otra cosa: la confianza. Suponiendo que sé lo que quiero que pase, ¿cómo sé que estas miles de líneas que un agente produjo en minutos hacen lo que creo que hacen?
Una de las respuestas clásicas de la industria del software son los tests. Y los tests, que los hay de diversos tipos, son buenos. Pero no podemos olvidar que un test es una muestra: prueba que el código funciona solo para los casos que fueron escritos por un ingeniero o un agente, dadas ciertas condiciones. Más aún, un agente que genera código plausible-pero-incorrecto produce exactamente el tipo de error que los tests no atrapan: el caso que nadie pensó en muestrear.
La otra respuesta de la industria, más nueva, es el harness: la capa de instrucciones, reglas y políticas que rodea al modelo y le dice qué no debe hacer —"no uses esta API", "no toques esa carpeta", "no inventes dependencias", "no subas el código a producción". Es útil y hoy es indispensable, pero comparte el defecto de fondo con los tests, solo que del otro lado: si el test es una muestra de los casos correctos que se nos ocurrieron, el harness es una lista de las prohibiciones que se nos ocurrieron. Ambos enumeran, y enumerar no escala: cada regla cubre el error que ya imaginaste, ninguna cubre el que no. Peor aún, el harness pide, no garantiza: descansa en que el modelo obedezca un texto, no en que la estructura impida la transgresión. A medida que los agentes ganan autonomía y horizonte, prohibir por enumeración se vuelve un juego que el prescriptor siempre va perdiendo —siempre falta una regla, siempre hay una forma de cumplir la letra y violar la intención. A largo plazo, decirle al modelo lo que no debe hacer no alcanza; hay que construir un mundo donde lo que no debe hacer ni siquiera se pueda expresar.
En contraste con ambos enfoques, ya contamos con una herramienta que no muestrea, que razona por construcción sobre clases enteras de errores, y que resulta ser —casi por accidente— el mejor mecanismo de retroalimentación que un agente puede tener: el sistema de tipos de un lenguaje de programación.
Este artículo es una apuesta. La apuesta es que la tradición que siguen lenguajes como Haskell no es una mera curiosidad académica que llegó demasiado pronto. Por el contrario, herramientas como tipos algebraicos, typeclasses con leyes y sistemas de tipos ricos son tecnología a la espera de que sea una máquina quien programa. Y que esa tradición no se queda solo en un programa, sino que escala hasta el nivel de arquitectura de un sistema.
El compilador como oráculo
Pensemos en qué necesita un agente para programar bien, y veremos que no difiere mucho de lo que necesita un programador humano.
Primeramente, no necesita inteligencia infinita, sino un bucle de retroalimentación que sea rápido, total y determinista. Rápido para poder iterar muchas veces. Total porque debe pronunciarse sobre todo el espacio de entradas posibles —al menos para la clase de errores que el tipo es capaz de capturar—, no sobre una muestra. Determinista para que el mismo error produzca la misma corrección.
Una suite de tests puede ser rápida, pero bajo ningún concepto es total. Una revisión humana podría ser total, pero es lenta y no determinista. Pero un type checker es las tres cosas a la vez. En otras palabras, cuando un agente escribe código mal tipado, el compilador rechaza el intento con un error estructurado, localizado y reproducible. El agente no tiene que adivinar si se equivocó (y un humano tampoco): se lo dicen, con precisión, en milisegundos.
Esto invierte la relación habitual. Es cierto que para un humano el sistema de tipos a veces se siente como un burócrata que te pide papeles, y uno muy complejo es molesto. Pero para un agente el sistema de tipos es un árbitro que corrige al instante. Cuanto más expresivo el sistema de tipos, más errores se vuelven errores de compilación, y más densa es la señal que guía al agente hacia el código correcto antes de que ejecute una sola línea.
La consigna, entonces, es anticipar tantos errores como se pueda del tiempo de ejecución al tiempo de compilación, utilizando diversas herramientas de lenguajes funcionales puros que iremos presentando. La primera, tipos algebraicos de datos.
Nivel programa: hacer irrepresentables los estados ilegales
La idea más poderosa y más subestimada del diseño con tipos algebraicos cabe en una frase, atribuida a Yaron Minsky: make illegal states unrepresentable —hacer que los estados ilegales ni siquiera se puedan expresar.
Consideremos una conexión de red modelada como la modelaría, por defecto, casi cualquiera, aunque esta vez usaremos Haskell como notación:
data Connection = Connection
  { isConnected :: Bool
  , socket      :: Maybe Socket
  , lastError   :: Maybe Error
  }
Esta estructura es simple de leer, sigue un diseño que encontramos a diario en la industria (un registro con campos, algunos opcionales), y a la vez es una trampa. Lo es porque permite estados que no tienen sentido: isConnected = True con socket = Nothing, es decir, conectado pero sin socket; o conectado y con error a la vez; o desconectado pero con un socket vivo. En realidad hay 2 × 2 × 2 combinaciones representables y solo unas pocas son legales. Cada combinación ilegal es un bug esperando a que un agente —o un humano cansado— lo escriba. Y en la industria la combinatoria en la mayoría de las entidades que encontramos a diario es incluso peor, porque números enteros o strings son tipos de datos con (casi) infinitas posibilidades.
¿Existe alternativa? Sí, en la jerga algebraica, con un tipo suma (lo que en otros lenguajes aparece como enums con datos, discriminated unions en TypeScript, sealed classes en Kotlin o enum con asociados en Swift/Rust):
data Connection
  = Disconnected
  | Connecting   RetryCount
  | Connected    Socket
  | Failed       Error
De esta otra forma los estados imposibles desaparecieron. No están prohibidos por una convención ni vigilados por un test: no existen en el espacio de lo expresable, porque en todo momento o se está en un caso con ciertos datos, o en otro con otros datos. Ningún agente va a poder producir "conectado sin socket", porque es inexpresable por diseño, y si lo intenta, estaría escribiendo algo que no compila. El error se atrapa en el punto más temprano y más barato posible: antes de ejecutar el programa, y no durante su ejecución.
Y como segundo beneficio, podemos sumar la exhaustividad del pattern matching: si mañana agrego un estado Reconnecting, el compilador marca cada lugar del sistema que olvidó manejarlo. Es refactorización guiada por el tipo: la herramienta te lleva de la mano por todos los sitios afectados. Para un agente que modifica una base de código grande, esto es invaluable —convierte "¿me olvidé de algún caso?" de una pregunta angustiante a una garantía mecánica.
Por su parte, el otro lado de los tipos algebraicos son los tipos producto: estructuras que combinan varios campos a la vez, como el primer Connection de arriba. El problema nunca fue el producto en sí, sino el producto sin restricciones; y la cura son los constructores inteligentes (smart constructors) combinados con newtypes (tipos que actúan como sinónimo de otro, pero con restricciones adicionales). En vez de pasar String por todos lados —teniendo así el famoso stringly-typed code— uno puede envolver el dato en un tipo que solo se puede construir validándolo de antemano:
newtype Email = Email Text          -- el constructor no se exporta

mkEmail :: Text -> Either Error Email
mkEmail t
  | isValid t  = Right (Email t)
  | otherwise  = Left InvalidEmail
Una vez que tenés un Email —que fue chequeado, por ejemplo, en la frontera del programa—, sabés que es válido, y eso queda como garantía en todo el resto del programa. En este caso el tipo se convierte en una prueba que lo garantiza. Alexis King, un conocido teórico de la programación funcional, lo resumió en una consigna que conviene tatuarse: parse, don't validate —parseá, no valides. En otras palabras, no verifiques un dato crudo en cada uso; transformalo una sola vez en un tipo que vuelve imposible el dato inválido luego.
Typeclasses: contratos componibles con leyes
Y la cosa no termina ahí. Los tipos algebraicos te dan vocabulario que invita a diseñar de modo que no se pueda expresar lo que no debería expresarse en un programa. Pero las typeclasses te dan interfaces con leyes, y las leyes son el mecanismo ideal para que las abstracciones compongan de forma predecible.
Para quienes no conocen las typeclasses, estas representan polimorfismo ad hoc (similar a las interfaces en Java u otros lenguajes): permiten definir operaciones que distintos tipos implementan a su manera.
La más famosa probablemente sea Eq, que define la operación de igualdad que diferentes tipos pueden implementar:
class Eq a where
  (==) :: a -> a -> Bool
Esta operación permite comparar dos valores de un mismo tipo a y obtener un resultado booleano. Pero vayamos a otro ejemplo menos conocido pero más ilustrativo: Semigroup, que define una operación de combinación:
class Semigroup a where
  (<>) :: a -> a -> a       -- combinar dos valores en uno
Hasta aquí es como una interfaz de cualquier lenguaje. Lo distintivo es que la typeclass viene con una ley que toda instancia debe respetar: asociatividad.
Esta ley se expresa de la siguiente manera, y es una propiedad que debe cumplirse para cualquier instancia de Semigroup:
(x <> y) <> z == x <> (y <> z)Y esto no es tan abstracto como parece: listas bajo concatenación, enteros bajo suma (o bajo máximo), diccionarios que se fusionan —todos son semigrupos—. La instancia para listas, por ejemplo, no es más que la concatenación:
instance Semigroup [a] where
  (<>) = (++)        -- [1,2] <> [3,4] == [1,2,3,4]
¿Por qué importa una ley en una interfaz? Porque convierte una promesa informal en un contrato verificable, y porque de ese contrato se siguen consecuencias gratis. Si tu operación de "combinar" forma un semigrupo, entonces —sin más trabajo— la asociatividad te deja reagrupar los cómputos a voluntad: podés paralelizar la combinación y distribuirla entre máquinas sin que el resultado cambie. Y si esa operación es además conmutativa e idempotente, el orden y las repeticiones dejan de importar. En eso se apoya, en el fondo, la teoría de los CRDTs (los tipos de datos replicados sin conflicto que hacen funcionar a los editores colaborativos): "encontrá la estructura algebraica correcta y la consistencia distribuida se sigue de leyes conocidas del álgebra abstracta".
Entonces, para un agente, las leyes son oro por dos razones. Primero, son especificaciones generables: de la ley de asociatividad se deriva automáticamente un test de propiedades (QuickCheck, Hedgehog) que prueba la implementación con cientos de casos aleatorios. Segundo, aunque tal vez más difícil de ver sin ser experto en el tema, es que las leyes restringen el espacio de implementaciones correctas: hay muchas formas de escribir una función de tipo a -> a -> a, pero pocas que además sean asociativas. Esto permite al agente podar el árbol de búsqueda de implementaciones correctas.
El gran salto: del programa al sistema
Aquí es donde la mayoría de las discusiones sobre tipos se detienen, y donde empieza lo interesante. Si ponemos a los agentes a programar aprovechando mayores niveles de abstracción, las ventajas ya presentadas aplican a funciones específicas, a un módulo entero o a un programa completo, los cuales no dejan de ser unidades de código. Sin embargo, una cuestión interesante es si la misma disciplina escala a la arquitectura de un sistema que junta dichas unidades de alguna manera: los límites entre servicios, los protocolos que utilizan, las formas de configuración que existen por fuera, el pipeline que despliega nuevas versiones del sistema, etc.
¿Cuál es la apuesta para este caso? La traducción es directa y vale la pena enunciarla como principio:
A nivel de programa, los tipos hacen irrepresentables los estados ilegales. A nivel de sistema, los tipos hacen irrepresentables las interacciones ilegales.
Veamos algunos mecanismos concretos.
Uno muy ilustrativo podría ser definir protocolos como máquinas de estado tipadas. Un protocolo es una secuencia legal de mensajes: no podés mandar datos antes del handshake, no podés cerrar una conexión dos veces. Si a los tipos algebraicos agregamos técnicas como phantom types o GADTs (mecanismos para llevar información extra —en este caso, el estado del protocolo— al nivel del tipo), resulta posible codificar ese estado en el tipo, de modo que las transiciones ilegales no compilen:
data Door (s :: DoorState) where
  MkDoor :: Door s

open  :: Door 'Closed -> Door 'Open
close :: Door 'Open   -> Door 'Closed
El truco es el mismo que con los constructores inteligentes: MkDoor no se exporta, y una puerta solo se obtiene a través de open/close, así que el estado anotado en el tipo ('Open, 'Closed) siempre refleja el estado real. Con este diseño —que, hay que reconocerlo, requiere un sistema de tipos más expresivo— intentar open sobre una puerta ya abierta es un error de tipo. Y esta técnica llevada al extremo es conocida como session types: el protocolo completo entre dos servicios se vuelve un tipo, y un cliente que viole la coreografía no compila. Y esto conviene repetirlo, queda garantizado que un cliente (un programa) que pase por el chequeo estático de un sistema de tipos con reglas adecuadas no compila. De esta forma el "contrato de API" deja de ser un PDF que alguien debería leer, o incluso un spec en formato json que un agente debería seguir, y se vuelve algo que una máquina verifica formalmente.
¿Y qué pasa con cuestiones como la de tener permisos para leer la configuración de una base de datos? La respuesta es codificar efectos en el tipo. En la mayoría de los lenguajes, mirar el tipo de una función no te dice si va a leer la base de datos, llamar a otro servicio por la red o incluso lanzar misiles —chiste habitual en la comunidad de Haskell, aunque dejó de ser metafórico en la actualidad—. Con un sistema de efectos (o effect system, en inglés), podemos codificar lo siguiente:
fetchUser :: Members '[Reader DbConfig, Error NotFound] r
          => UserId -> Eff r User
El tipo de fetchUser declara exactamente qué puede hacer esta función: leer config de base de datos y fallar con "no encontrado". Y no puede mandar emails ni escribir archivos, porque esos efectos no están en su tipo. A nivel de arquitectura esto es enorme: las capacidades de cada componente quedan documentadas y verificadas en su tipo. Y un agente que intente colar una llamada de red en una función "pura de cómputo" (i.e., sin efectos) choca contra el tipo. La revisión de seguridad "¿este módulo puede hacer X?" pasa de auditoría manual (o automatizada) a chequeo estático en tiempo de compilación.
Y hay mucho más por explorar, como configuraciones tipadas (algo valioso en sistemas distribuidos), o incluso arquitecturas de microservicios como tipos (donde cada servicio es un tipo con sus propias leyes, y la composición de servicios se vuelve composición de tipos). Pero por ahora, lo importante es que el mismo principio de "hacer irrepresentable lo ilegal" que aplicamos a funciones individuales, se puede aplicar a la arquitectura completa del sistema, y así garantizar que ciertas clases enteras de errores por diseño ni siquiera puedan ser expresadas. Este es, esencialmente, el programa de Domain Modeling Made Functional de Scott Wlaschin, escalado: modelás el dominio —y luego el sistema— con tipos tan precisos que el código incorrecto se vuelve literalmente inexpresable.
Si bien estas ideas no son tan mainstream, lenguajes de sistemas como Rust llevan estos mecanismos al metal: su sistema de ownership es un sistema de tipos que hace irrepresentables clases enteras de errores de memoria y concurrencia, en compilación, sin recolector de basura.
La gran apuesta: el bucle agéntico tipado
Juntemos las piezas. ¿Cómo se ve, concretamente, un agente programando en este régimen? Claramente no es "el agente escupe código y rezamos". Es un bucle con guardrails en cada paso.
1. Especificación como tipo, primero. Antes de implementar, el agente (o un agente planificador) escribe el tipo de las unidades de código que vaya a implementar. Es decir, el tipo pasa a ser la especificación. Una función parse :: Text -> Either Error Ast declara su contrato antes de existir. En sistemas de tipos ricos, el tipo por sí solo descarta la mayoría de las implementaciones erróneas; existe incluso el folklore de "si type-checkea, probablemente es correcto", que la parametricidad ("theorems for free", de Wadler —la idea de que el tipo de una función genérica restringe tanto lo que puede hacer que ciertas propiedades quedan demostradas con solo mirar la firma) hace riguroso para funciones polimórficas: el tipo restringe tanto el comportamiento que ciertas propiedades se siguen gratis del tipo de una función.
2. Síntesis y búsqueda dirigidas por tipos. El agente no busca en el vacío. Herramientas como Hoogle permiten buscar funciones útiles simplemente por su tipo. O incluso los typed holes (un mecanismo utilizado en Haskell para dejar un hueco a completar luego) dejan que el agente escriba _ en medio de una expresión y le pregunte al compilador "¿qué tipo va aquí, y qué tengo disponible que lo produzca?". La síntesis dirigida por tipos (la línea de Synquid, la búsqueda de pruebas de Idris) convierte una especificación-tipo en candidatos de implementación. El espacio de búsqueda del agente está podado por el tipo en cada paso.
3. Generar, compilar, refinar. El agente propone, el compilador dispone. Cada intento mal tipado vuelve con un error estructurado que el agente usa para corregir. Es el bucle de oráculo del que hablamos: rápido, total, determinista.
4. Una segunda compuerta: refinamientos y propiedades. Los tipos básicos no capturan todo. "Esta lista está ordenada", "este índice está en rango", "esta función termina" requieren más. Aquí entran los tipos refinados (Liquid Haskell, donde un tipo lleva un predicado lógico que verifica un SMT solver —un motor que decide automáticamente fórmulas lógicas) y los tipos dependientes (Idris, Agda, donde los tipos pueden depender de valores). El agente codifica pre y postcondiciones, y un verificador automático las comprueba. Lo que no llega al tipo, se cubre con tests de propiedades derivados de las leyes.
5. El punto culminante: el agente construye su propia validación. Esto es lo que distingue al desarrollo agéntico maduro. El agente no solo escribe código que pasa los chequeos existentes: construye los chequeos. Cuando modela un dominio nuevo, emite junto al código los constructores inteligentes que custodian las fronteras, las typeclasses que codifican las leyes del dominio, las instancias que las satisfacen, las propiedades de QuickCheck que las prueban, los predicados de refinamiento, y cuando hace falta, pequeñas pruebas formales (Liquid Haskell, Idris, Dafny, F*, Lean). El arnés de verificación se vuelve un entregable de primera clase, no un apéndice. Y como ese arnés está, a su vez, tipado y compilado, no puede mentir silenciosamente.
Imaginá un agente al que le pedís un sub-sistema de saldos contables. En lugar de devolver funciones y unos tests de ejemplo, te devuelve: un tipo suma para las transiciones de cuenta donde las transiciones ilegales no compilan; una instancia de semigrupo conmutativo para combinar libros mayores, con sus leyes de asociatividad y conmutatividad; un test de propiedades que prueba que fusionar réplicas converge sin importar el orden; y un refinamiento que garantiza que ningún saldo cruza a negativo sin un asiento de descubierto explícito. El "código" y "la prueba de que el código es correcto" llegan en el mismo commit, y ambos compilan.
Honestidad: dónde la apuesta tiene costos
Sería deshonesto vender esto como gratis. Tiene fricciones reales y conviene nombrarlas.
Los sistemas de tipos ricos tienen una curva de aprendizaje pronunciada —aunque, curiosamente, el agente la absorbe mejor que muchos humanos, porque para éste el compilador es señal, no regaño. Y además hay un trade-off entre expresividad y decidibilidad, que los que nos dedicamos a razonar sobre sistemas de tipos conocemos muy bien: cuanto más querés expresar en un tipo, más te acercás a tipos dependientes donde contar con un mecanismo automático de inferencia de tipos ya no resulta decidible, lo cual implica un mayor esfuerzo en la verificación. En otras palabras, no toda propiedad es razonablemente expresable como un tipo, e incluso casos como "este modelo de machine learning es justo" o "esta UI es bonita" no son fácilmente especificables de esta manera.
Los tipos también mienten si el programa usa escotillas que apagan al chequeador. Haskell, por ejemplo, cuenta con unsafePerformIO, que saltea el seguimiento de efectos; TypeScript con any, que desactiva el chequeo de tipos; y Rust con los bloques unsafe, que suspenden las garantías del borrow checker. Y un agente que del otro lado del compilador tiene un sistema de tipos débil puede engañar al chequeador en lugar de satisfacerlo —por eso la fortaleza del sistema de tipos importa, y por eso prohibir las escotillas en código generado es una política sensata.
Y queda siempre la frontera con el mundo no tipado: red, disco, JSON, entrada de usuario. Ahí no hay tipos que valgan hasta que parseás. Por eso parse, don't validate es la disciplina de frontera: concentrás la incertidumbre en un borde fino y bien custodiado, y dejás el interior del sistema demostrablemente sano.
No obstante, consideramos que ninguna de estas objeciones hunde la apuesta. Solo delimitan dónde rinde: en la lógica de dominio, los protocolos, los límites y los invariantes, que es exactamente donde los agentes producen los bugs más caros y sutiles.
Hacia una arquitectura demostrable
Hay una simetría que vale la pena ver completa. Durante décadas, expresar tipos complejos en sistemas de tipos avanzados fue un lujo: pagabas un costo de diseño por adelantado para evitar bugs que un humano disciplinado podía, con suerte, evitar de otras formas (testing unitario, etc.). Eso hacía que el cálculo no siempre cerrara, y por eso la mayoría del software está escrito en lenguajes laxos (como Python, Ruby, PHP o JavaScript), aunque algunos nichos aprovecharon lenguajes como OCaml, Haskell o Scala para implementar alguna parte (empresas como Jane Street, IOHK, NoRedInk, etc., solo por mencionar algunas).
Pero este artículo intenta mostrar que los agentes rompen esa simetría. Cuando el código en abundancia es más barato, el costo de diseñar buenos tipos se amortiza sobre muchísima generación, y el beneficio —rechazar por construcción clases enteras de error que ningún test muestrearía— se multiplica. El sistema de tipos deja de ser el burócrata del humano y se vuelve el lenguaje de especificación y la valla de seguridad de la máquina.
El trabajo humano ya se encuentra siendo desplazado hacia arriba: ya no escribimos cada función. Hoy día nos encontramos declarando intenciones a través de diversas formas de especificación. Entonces, me pregunto, por qué no hacerlo en forma de propiedades o leyes: declarar qué estados son legales, qué interacciones tienen sentido, qué invariantes no pueden romperse jamás. El agente habita ese espacio acotado, explora libremente, y no puede caerse porque el compilador es una valla de seguridad. La verificación, por primera vez, escala al mismo ritmo que la generación —porque buena parte de ella la genera y la chequea la propia máquina.
La tradición funcional —tipos algebraicos para hacer irrepresentable lo ilegal, typeclasses con leyes para componer con confianza, sistemas de tipos ricos para subir errores a compilación— parecía adelantada a su tiempo. Quizá no estaba adelantada. Quizá estaba esperando que el programador fuera una máquina que necesitara, más que nadie, que la verdad sobre el código se pudiera verificar mecánicamente.
Los fundadores de Haskell tenían razón, ya en 1989 John Hughes, uno de ellos, defendía en Why Functional Programming Matters por qué esta forma de programar importaba. Solo que el público al que más le sirven dichos conceptos acaba de llegar, es artificial, y es el que más necesita aprovecharlos.
Referencias
- Hughes, J. (1989). Why Functional Programming Matters. The Computer Journal, 32(2), pp. 98–107. URL: https://doi.org/10.1093/comjnl/32.2.98
- Minsky, Y. (2011). Effective ML Revisited (origen de la consigna make illegal states unrepresentable). Jane Street Tech Blog. URL: https://blog.janestreet.com/effective-ml-revisited/
- King, A. (2019). Parse, don't validate. Blog «Alexis King». URL: https://lexi-lambda.github.io/blog/2019/11/05/parse-don-t-validate/
- Shapiro, M., Preguiça, N., Baquero, C. & Zawirski, M. (2011). Conflict-Free Replicated Data Types. SSS 2011 — Symposium on Self-Stabilizing Systems, pp. 386–400. URL: https://doi.org/10.1007/978-3-642-24550-3_29
- Claessen, K. & Hughes, J. (2000). QuickCheck: A Lightweight Tool for Random Testing of Haskell Programs. ICFP 2000 — International Conference on Functional Programming, pp. 268–279. URL: https://doi.org/10.1145/351240.351266
- Honda, K., Vasconcelos, V. T. & Kubo, M. (1998). Language Primitives and Type Discipline for Structured Communication-Based Programming (session types). ESOP 1998 — European Symposium on Programming, pp. 122–138. URL: https://doi.org/10.1007/BFb0053567
- Wlaschin, S. (2018). Domain Modeling Made Functional: Tackle Software Complexity with Domain-Driven Design and F#. The Pragmatic Bookshelf. URL: https://pragprog.com/titles/swdddf/domain-modeling-made-functional/
- The Rust Project (s.f.). Understanding Ownership. The Rust Programming Language (libro oficial). URL: https://doc.rust-lang.org/book/ch04-00-understanding-ownership.html
- Wadler, P. (1989). Theorems for Free! FPCA 1989 — Functional Programming Languages and Computer Architecture, pp. 347–359. URL: https://doi.org/10.1145/99370.99404
- Mitchell, N. (s.f.). Hoogle — búsqueda de la API de Haskell por tipo. haskell.org. URL: https://hoogle.haskell.org/
- Polikarpova, N., Kuraj, I. & Solar-Lezama, A. (2016). Program Synthesis from Polymorphic Refinement Types (Synquid). PLDI 2016 — Programming Language Design and Implementation, pp. 522–538. URL: https://doi.org/10.1145/2908080.2908093
- Brady, E. (2017). Type-Driven Development with Idris. Manning Publications. URL: https://www.manning.com/books/type-driven-development-with-idris
- Vazou, N., Seidel, E. L., Jhala, R., Vytiniotis, D. & Peyton Jones, S. (2014). Refinement Types for Haskell (Liquid Haskell). ICFP 2014 — International Conference on Functional Programming, pp. 269–282. URL: https://doi.org/10.1145/2628136.2628161
- Leino, K. R. M. (2010). Dafny: An Automatic Program Verifier for Functional Correctness. LPAR-16 — Logic for Programming, Artificial Intelligence and Reasoning, pp. 348–370. URL: https://doi.org/10.1007/978-3-642-17511-4_20
Publicado también en Medium