De la Invención a la Deducción: Reclamando la Ingeniería en la era de la GenAI
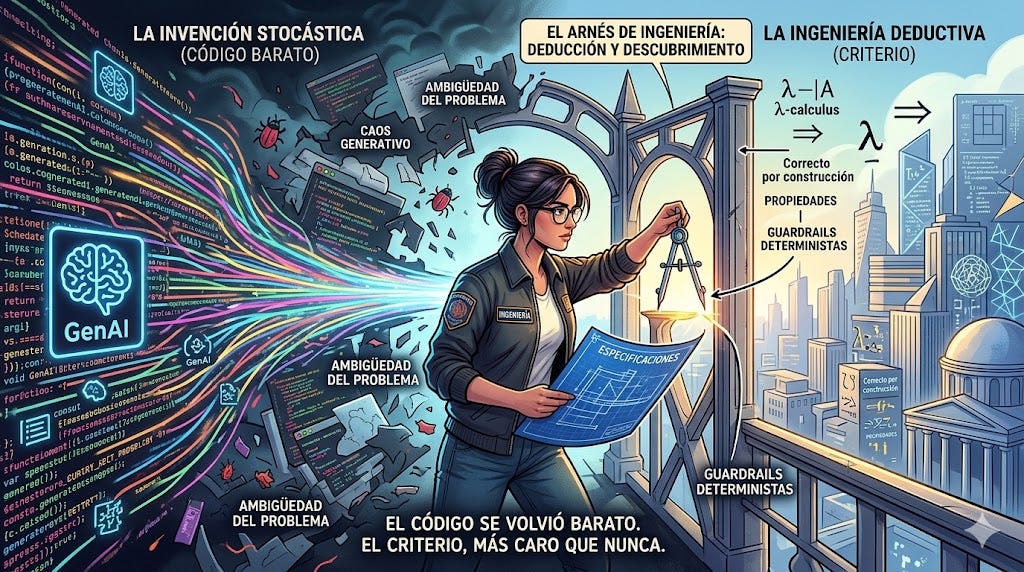
Hay dos creencias que dominan el desarrollo de software hoy, y las dos son medias verdades. La primera: “el código es barato”, que ya cubrimos en un artículo anterior. Y una segunda, más silenciosa pero más peligrosa: “ya conocemos bien cuál es el problema”.
La primera es simplemente cierta, dado que nunca fue tan fácil generar líneas de código, que además suelen funcionar. Pero la segunda casi nunca lo es. Y cuando las juntás, obtenés la trampa del momento: máquinas que producen soluciones a velocidad industrial para problemas que todavía no terminamos de entender. Y con una visión holística y de más largo plazo, el cuello de botella nunca fue escribir, sino saber qué escribir, y por qué.
Lo que propongo en este artículo es que, para no perder el norte, conviene volver a dos ideas viejas — anteriores a todo este ciclo de hype — : el desarrollo como descubrimiento y la programación como deducción. Una nos invita a comprender mejor el problema. La otra, cómo construir la solución sin que se nos desarme en las manos.
1. El desarrollo como proceso de descubrimiento
Dave Farley — uno de los autores del libro que definió la Entrega Continua — tiene una tesis incómoda para los entusiastas de la automatización total: el cuello de botella de la ingeniería nunca fue escribir código.
Su argumento es que la ingeniería de software no consiste en transcribir requisitos a un lenguaje de programación. Consiste en aprender sobre el dominio mientras intentamos resolverlo. El requisito que te pasaron al inicio del proyecto casi nunca es el problema real; es una primera aproximación que se va corrigiendo a medida que construís, mostrás, y descubrís lo que la gente necesitaba de verdad.
Y acá hay una asimetría que se nota poco: el problema real casi nunca está escrito en ningún lado. Vive repartido entre lo que el negocio cree que necesita, lo que el usuario hace de verdad, y las restricciones que nadie mencionó porque “son obvias”. Construir software es, en buena parte, el trabajo de descubrir ese problema — no recibirlo.
Eso no quita que la IA ayude con partes genuinas de esto: explora un codebase ajeno, te resume documentación, te explica qué hace un módulo que nunca viste. Pero todo eso es ayuda para navegar lo que ya existe. El salto que no da por vos es el otro: decidir cuál es el problema que vale la pena resolver. Te acelera la construcción de la solución — y a veces hasta la comprensión del terreno — , pero la pregunta de qué construir y por qué sigue siendo tuya.
En otras palabras, la IA acelera la parte de generar, y generar siempre fue lo más fácil — aun cuando sea extenso y demande tiempo — . Lo difícil sigue siendo juzgar si lo generado resuelve el problema en su contexto completo: seguridad, escalabilidad, mantenibilidad, las necesidades humanas reales detrás del ticket. Y ese juicio sigue siendo nuestro.
El riesgo concreto es de velocidad mal aplicada. Sin una disciplina de pasos pequeños y reversibles — sin Entrega Continua de verdad — la GenAI no te lleva más rápido a la solución. Te lleva más rápido al desastre. Es una bomba de complejidad con la mecha ya encendida: cada commit generado sin validación real es deuda que vas a pagar con intereses, y los intereses de la complejidad se acumulan rápido. Escribí sobre esta trampa en detalle en “Code is cheap”: el engaño moderno que podría salir carísimo — cómo la IA, sin un marco de diseño sólido, no frena la entropía del software sino que la acelera.
2. Descubrimiento vs. invención: lo que enseña Philip Wadler
Si Farley habla del descubrimiento del problema, Philip Wadler nos obliga a pensar en el descubrimiento de la solución.
En su charla “Propositions as Types”, Wadler defiende una idea que al principio suena casi mística pero tiene fundamento matemático sólido: las buenas estructuras de nuestras soluciones — cuando son correctas — no se inventan. Se descubren.
El corazón de su argumento es el isomorfismo de Curry-Howard. Dicho sin jerga: hay una correspondencia exacta entre la lógica y los sistemas de tipos. Una proposición lógica se corresponde con un tipo. Una demostración de esa proposición se corresponde con un programa de ese tipo. No es una analogía bonita; es la misma estructura matemática vista desde dos disciplinas que la encontraron por separado — los lógicos y los informáticos — sin saber que estaban mirando lo mismo.
¿Por qué importa esto en un artículo sobre IA? Porque cambia el estatus de lo que hacemos. Si un lenguaje está basado en el cálculo lambda — como Haskell y varios otros — , no estamos usando una herramienta arbitraria que algún humano inventó por conveniencia. Estamos usando leyes lógicas que ya estaban ahí, esperando a ser aprovechadas. Como dice Wadler, una inteligencia alienígena que nunca haya visto un teclado descubriría las mismas estructuras. Eso es lo opuesto a una ocurrencia: es un hallazgo.
Y si las estructuras correctas se descubren, entonces la pregunta del ingeniero deja de ser “¿qué invento?” y pasa a ser “¿qué leyes gobiernan esto, y cómo construyo de acuerdo a ellas?”. Esa es la puerta de entrada a la deducción — y a una idea que vamos a desarrollar en la sección 4: la de construir de forma tal que la corrección se siga de la estructura.
3. La tensión — y por qué es productiva
Acá aparece la gran diferencia entre los dos mundos, y es justamente lo que hace interesante ponerlos juntos.
Farley nos dice que el problema es una entidad externa, desordenada, parcialmente desconocida. Se descubre desde afuera, con experimentación y feedback constante. Es empírico.
Wadler nos dice que el modelo de la solución — los tipos, la lógica — debe ser un sistema deductivo. No una creatividad libre de reglas, sino una construcción que se sostiene sobre fundamentos. Es formal.
No se contradicen, se complementan. El buen ingeniero vive en los dos registros a la vez. Explora el problema como un científico — hipótesis, experimento, corrección — y construye la solución como un matemático — del fundamento hacia arriba, sin pasos injustificados.
La GenAI, librada a sí misma, no hace ninguna de las dos cosas. Y ese es el punto del artículo.
4. De la verificación a la construcción
El modo por defecto de un modelo generativo es la invención estocástica: produce código que se parece a código correcto, porque está hecho de patrones probabilísticos extraídos de millones de ejemplos. A veces acierta. A veces produce algo que compila, pasa una prueba superficial, y falla en el caso noventa y siete que nadie miró.
Un ejemplo concreto: le pedís a un modelo una función que parsee fechas. Te devuelve algo que funciona perfecto con 2024-03-15. Anda en la demo, anda en el happy path. Lo que no ves es que rompe con años bisiestos, con zonas horarias, o con el formato que usa justo el proveedor del que dependés. El código parecía correcto. Esa es exactamente la trampa.
La verdadera ingeniería se inclina hacia la deducción: en lugar de generar y después verificar, se trata de construir de forma tal que la corrección se siga de la estructura. Es la diferencia entre probar que algo anda y hacer que no pueda no andar. Esto tiene un nombre viejo: correcto por construcción.
Hay un abanico de herramientas que empujan en esa dirección, con distinto grado de rigor — y conviene verlas como un espectro, no como una sola bala de plata.
El property-based testing es una de las más accesibles. En lugar de probar casos sueltos elegidos a mano — que es justo donde se esconden los bugs — , definís las leyes que la función debe cumplir siempre. Por ejemplo: “para cualquier lista, revertirla dos veces devuelve la lista original”, o “parsear una fecha y volver a serializarla produce la cadena original”. La herramienta entonces genera cientos de casos, incluidos los raros que no se te hubieran ocurrido, e intenta romper la ley.
Esto no quiere decir que los tests unitarios, los de integración o el QA — automatizado o manual — sobren. Son valiosos, porque previenen regresiones conocidas y atrapan lo que ya sabés que puede romperse. Pero todos comparten un techo: son comprobaciones basadas en ejemplos. Dado este input, espero este output. Y un ejemplo, por definición, solo cubre los casos que se te ocurrieron o que lograste descubrir de alguna manera. Haber demostrado una propiedad es otra cosa: es haber cubierto el espacio entero de inputs posibles, incluidos los que ningún humano hubiera pensado en escribir. El ejemplo verifica un punto; la propiedad verifica una ley.
Desarrollé esto en detalle en QuickCheck vs. testing tradicional como arnés determinista en la era de GenAI, con un caso concreto: un agente que implementa descuentos para un carrito de compras, escribe código que pasa los tests unitarios obvios, y sin embargo viola una propiedad básica del dominio — un descuento mal acotado que termina pagándole al cliente por comprar. Ningún test basado en ejemplos lo atrapa, salvo que un humano específicamente piense en ese caso. La propiedad sí, porque define el contrato que el código debe cumplir siempre.
Pero — y este es el punto — el property-based testing sigue siendo, en el fondo, verificación: actúa después de la generación. Es un arnés excelente, pero no el destino final.
El escalón más profundo: la mirada denotacional
El destino final es construir de modo que el error no se pueda expresar. Y para eso hace falta cambiar la pregunta.
La mirada denotacional consiste en pensar un programa por lo que significa — su denotación matemática — antes que por lo que hace paso a paso. Cuando razonás denotacionalmente, la pregunta no es “¿qué hace este código?” sino “¿qué es esta función, matemáticamente, y qué leyes la gobiernan?”. Y si la estructura está bien elegida, clases enteras de error directamente no se pueden expresar. El tipo no permite el estado inválido. La composición no permite la combinación incoherente. No cazás bugs, los volvés inexpresables.
Esta no es una idea nueva. John Hughes la planteó en “Why Functional Programming Matters” (1990), un ensayo que envejeció sorprendentemente bien. Su tesis: a medida que el software se vuelve más y más complejo, estructurarlo bien se vuelve más importante, no menos — porque el software bien estructurado es más fácil de escribir, de depurar, de entender y ofrece módulos reutilizables que abaratan el trabajo futuro. Y la afirmación que lo corona: la modularidad es la clave de la programación que tiene éxito (siempre pensando a largo plazo).
Hughes no se quedó en la consigna. Mostró mecanismos concretos para lograr esa modularidad — las funciones de orden superior y la evaluación lazy — : piezas que se combinan según leyes razonables, no por coincidencia. Esa capacidad de composición es justamente lo que vuelve un sistema tratable, porque te deja razonar sobre las partes y confiar en que el todo se sostiene.
Treinta y cinco años después, con máquinas generando volumen de código a destajo, su punto se vuelve urgente. Si la estructura es lo que mantiene tratable al software, y delegás la generación sin cuidar la estructura, estás automatizando la parte fácil mientras erosionás la difícil. La modularidad de Hughes y el isomorfismo de Wadler apuntan al mismo lugar: si vas a delegar el cómo a una máquina, más te vale tener una forma rigurosa de razonar sobre el qué. El punto de vista denotacional es exactamente esa forma — y deja de ser una preferencia académica para volverse infraestructura crítica.
Y notá el paralelo con la sección 1: así como el problema se descubre en lugar de inventarse, las propiedades correctas de una función no se inventan tampoco — se descubren interrogando el dominio. “¿Qué tiene que ser verdad siempre?” es una pregunta de exploración, no de ocurrencia. La diferencia de mentalidad es total: el vibe coding, con revisión automática o manual, pregunta “¿esto anda?”. La deducción pregunta “¿qué tiene que ser verdad para que esto sea correcto?” — y construye a partir de esa respuesta.
5. Guardrails deterministas en un mundo no-determinista
La producción de software con IA es, por naturaleza, no-determinista. Y mucha gente lo olvida: el mismo prompt te puede dar dos respuestas distintas. Para que eso sea seguro en producción, necesitás envolver ese proceso impredecible en una capa de controles que sí sean predecibles. Guardrails deterministas que guíen y corrijan la generación.
Hay tres que llevan décadas de investigación y tienen, por lo tanto, una base sólida que podemos aprovechar.
Sistemas de tipos fuertes. Un buen sistema de tipos funciona como una demostración matemática integrada al código: hay clases enteras de errores que directamente no se pueden expresar. Si el modelo genera algo incoherente, no compila. El tipo es la primera línea de defensa, y es gratis en el sentido de que no requiere disciplina humana para ejecutarse — simplemente está. Es la mirada denotacional de la sección anterior, hecha herramienta cotidiana.
Pipelines de CD rigurosos. El valor de la Entrega Continua acá no es la velocidad de deploy; es que cada cambio se valida en minutos, no en días. Cuando la IA puede generar veinte cambios en una tarde, necesitás veinte validaciones automáticas esa misma tarde. Un pipeline lento convierte la velocidad de la GenAI en una acumulación de cambios sin verificar — lo peor de los dos mundos.
Métodos formales ligeros. No hace falta demostrar formalmente todo el sistema, sabemos que eso es extremadamente costoso y no es práctico en la mayoría de los casos. Pero razonar explícitamente sobre las propiedades clave — invariantes, precondiciones, qué tiene que valer siempre — le da al proceso de generación una estructura sobre la cual apoyarse. El property-based testing de la sección anterior es la versión práctica y accesible de esta idea, aunque existen otras que hoy día son también practicables, dado que la IA escribe gran parte del texto requerido (y esto lo veremos en próximos artículos).
El patrón común a los tres: son automáticos y son inflexibles. No dependen de que un humano cansado revise bien a las seis de la tarde. Esa es justamente la propiedad que los hace confiables.
6. El humano “on the loop”
Kief Morris introdujo recientemente una distinción que ordena todo lo anterior: el humano in the loop versus el humano on the loop.
In the loop — dentro del bucle — es el humano como gatekeeper, revisando línea por línea lo que la IA produce. Es agotador, no escala, y es profundamente propenso al error: revisar código generado todo el día es una de las tareas más fatigantes que existen, y eso termina liberando bugs. Te convertís en un parche humano sobre un proceso que te supera en volumen.
On the loop — sobre el bucle — es otra cosa. El humano diseña y gestiona el arnés de ingeniería. En vez de micro-gestionar cada artefacto de código, construye el sistema que controla a los agentes: las especificaciones, las pruebas, los mecanismos de feedback, los guardrails de la sección anterior.
Esto, vale aclararlo, no significa atiborrar al modelo de reglas. Una especificación no es una cárcel de restricciones: cada restricción de más recorta el espacio de soluciones que el modelo puede explorar, y muchas veces lo terminás forzando a optimizar para tus reglas en lugar de para tu problema. El humano on the loop no dicta leyes inquebrantables; manifiesta tensiones conscientes — las fuerzas en conflicto que el modelo debe resolver — y deja el razonamiento donde tiene que estar. Exploré esa distinción entre especificar más y especificar mejor en Tensión en el diseño de software.
Pero como lo plantea Morris, el lugar del humano es construir el bucle de trabajo — no ser una pieza dentro de su engranaje. Nosotros definimos el qué y el por qué. La IA explora el cómo sobre esas bases, pero dentro de un recinto cuyas paredes pusimos nosotros.
Y notá que esto reconecta con todo lo anterior: el arnés es el descubrimiento de Farley y la deducción de Wadler hechos infraestructura. Las pruebas codifican lo que aprendimos del problema. Los tipos codifican la lógica de la solución. El humano on the loop no es alguien que dejó de hacer ingeniería — es alguien que la hace en una capa más alta de abstracción.
Conclusión
La ingeniería de software no está muriendo. Está mudando de piel.
Estamos dejando de ser artesanos de la sintaxis — esa parte, sinceramente, la IA la hace bien — para volvernos arquitectos de sistemas de descubrimiento y deducción. El valor ya no está en escribir cada función. Está en saber qué funciones hacen falta (descubrimiento), en definir qué propiedades deben cumplir y construir el sistema de modo que la corrección derive de su propia estructura (deducción), y en levantar el arnés que mantiene honesto (o confiable) a todo el proceso (los guardrails).
Farley y Wadler, leídos juntos, dibujan el mapa: el futuro pertenece a quienes pueden navegar la ambigüedad del mundo real con la disciplina empírica del descubrimiento, y además que posean el conocimiento necesario para poder construir soluciones sobre las leyes inmutables de la lógica y la matemática. Siempre sobre el bucle. Siempre con la mano firme en los guardrails.
El código se volvió barato. El criterio, más caro que nunca.
Referencias y lecturas relacionadas
- “Why AI WON’T Replace Software Engineering” — Dave Farley. Por qué la ingeniería es un proceso de aprendizaje continuo y por qué código barato no equivale a software de calidad.
- “Propositions as Types” — Philip Wadler (Communications of the ACM, 2015; charla homónima). La programación y la lógica como dos caras de la misma moneda descubierta, no inventada.
- “Why Functional Programming Matters” — John Hughes (1990). La modularidad y la composición como claves de la programación exitosa.
- “Harness Engineering” y escritos recientes sobre IA y desarrollo — Martin Fowler y colaboradores (martinfowler.com). Origen de la distinción in the loop / on the loop y del concepto de arnés de ingeniería.
De esta misma serie:
- “Code is cheap”: el engaño moderno que podría salir carísimo
- QuickCheck vs. testing tradicional como arnés determinista en la era de GenAI
- Tensión en el diseño de software: por qué especificar más no es especificar mejor
- El espejismo de la velocidad: por qué la arquitectura acelera y las herramientas solo tipean más
- El colapso de la mente de von Neumann
Publicado también en Medium